Milenianews.com, Depok – Ketika kecerdasan buatan semakin pintar memahami bahasa yang digunakan mayoritas manusia, ada bahasa-bahasa lain yang justru berisiko tidak terdengar di ruang digital. Persoalan itulah yang coba dijawab tim peneliti Universitas Nusa Mandiri (UNM) bersama Badan Riset dan Inovasi Nasional (BRIN) melalui pengembangan chatbot khusus bahasa daerah perbatasan Indonesia.
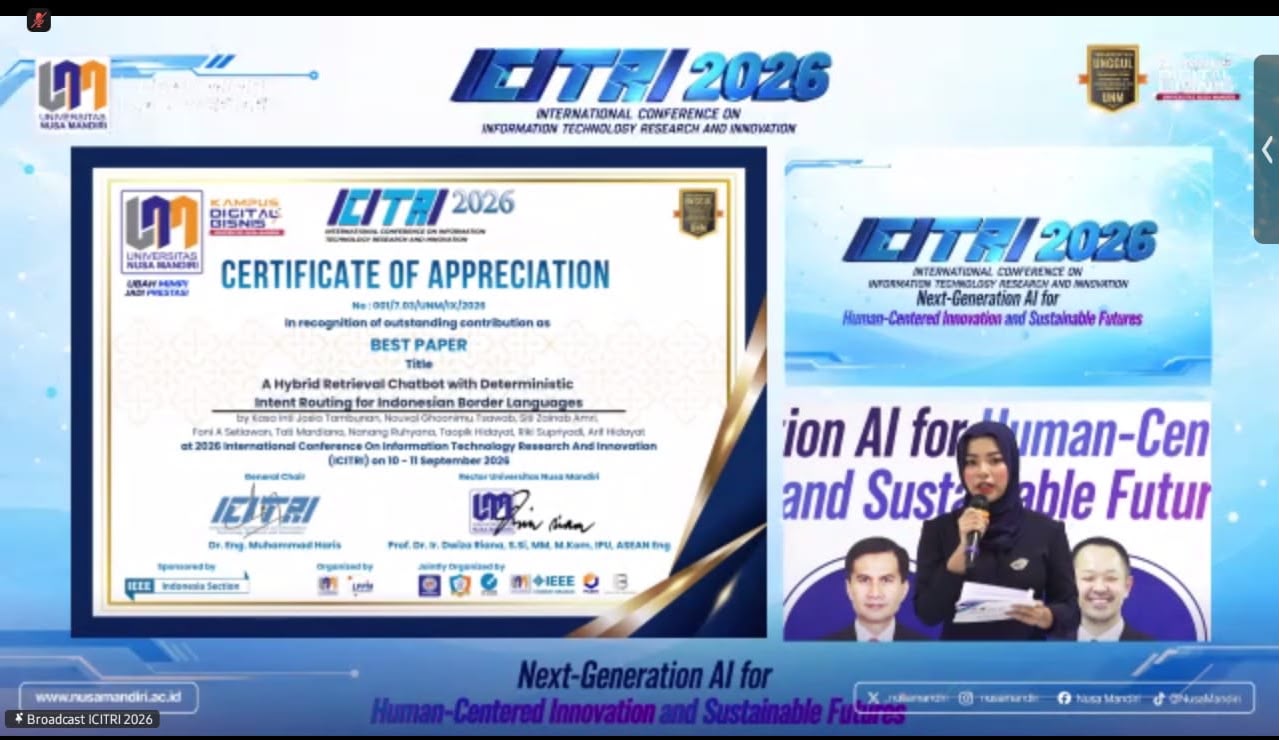
Riset berjudul “A Hybrid Retrieval Chatbot with Deterministic Intent Routing for Indonesian Border Languages” tersebut berhasil meraih salah satu penghargaan Best Paper dalam International Conference on Information Technology and Research Innovation (ICITRI) 2026 yang diselenggarakan UNM. Penghargaan diumumkan pada hari kedua konferensi yang berlangsung secara hybrid di UNM Kampus Margonda dan melalui platform Zoom, Jumat (11/9).
Baca juga: Riset AI Deteksi Kanker Payudara Raih Best Paper ICITRI 2026
Chatbot AI Bahasa Daerah Perbatasan Indonesia
Penelitian ini diketuai Kasa Inti Josia Tambunan bersama rekannya Nouval Ghoonimu Tsawab, Siti Zainab Amri, Foni Agus Setiawan dari BRIN, Nanang Ruhyana, Taopik Hidayat, Tati Mardiana, Riki Supriyadi, dan Arif Hidayat dari UNM. Ketua Tim Peneliti, Kasa Inti Josia Tambunan, mengungkapkan latar belakang di balik pengembangan chatbot ini.
“Kami melihat adanya ketimpangan yang cukup besar dalam ekosistem AI global saat ini. Bahasa-bahasa daerah di perbatasan Indonesia sering kali diabaikan karena minimnya sumber daya data komputasi. Jika tidak ada intervensi teknologi yang tepat, bahasa-bahasa lokal ini berisiko terpinggirkan dan bahkan hilang di ruang digital,” ujar Kasa dalam rilis yang diterima milenianews.com, Senin (14/9).
Indonesia memiliki lebih dari 700 bahasa daerah, tetapi jumlah tersebut belum otomatis membuat seluruh bahasa mendapatkan ruang yang sama dalam ekosistem teknologi digital. Delapan bahasa daerah perbatasan di Kalimantan, yakni Iban, Bidayuh, Kanayatn dengan dialek Salako, Tamambaloh atau Embaloh, Melayu Sanggau, Bakatik, Taman, dan Bukat, masih menghadapi keterbatasan sumber daya komputasi serta representasi dalam korpus pelatihan Large Language Models (LLM) global.
Keterbatasan tersebut menimbulkan persoalan ketika chatbot generatif digunakan untuk menjawab pertanyaan mengenai bahasa-bahasa yang minim sumber daya. Alih-alih memberikan informasi yang bersumber dari data linguistik yang valid, model AI dapat menghasilkan hallucination atau jawaban yang terdengar meyakinkan tetapi tidak sesuai dengan fakta.
Padahal, bagi bahasa daerah yang jumlah penuturnya terbatas, kesalahan semacam itu bukan sekadar persoalan teknis. Ketika data bahasa tidak tersedia secara baik dalam sistem digital, perkembangan teknologi AI juga berpotensi semakin menjauh dari keragaman bahasa yang hidup di masyarakat.
Sebelumnya, sumber daya linguistik untuk bahasa-bahasa tersebut telah dihimpun melalui platform Bahasan. Platform tersebut mengarsipkan ribuan entri leksikal, contoh percakapan, serta dokumen ilmiah dari komunitas penutur asli dan berbagai sumber akademik.
Masalah berikutnya justru muncul dari cara pengguna mengakses informasi tersebut. Pengguna masih harus menelusuri situs secara manual ketika ingin mencari arti kata, contoh penggunaan, maupun informasi yang lebih konseptual mengenai bahasa daerah tertentu.
Tim peneliti kemudian mengembangkan chatbot hibrida yang menghubungkan pengguna dengan berbagai sumber informasi linguistik tersebut. Sistem ini tidak menyerahkan seluruh proses kepada LLM, tetapi membagi penanganan pertanyaan ke dalam beberapa jalur berdasarkan jenis informasi yang dibutuhkan.
Baca juga: Prof. Celia Shahnaz Ungkap Wajah AI yang Makin Humanis di ICITRI 2026
Jalur pertama adalah Dictionary Lookup yang digunakan untuk menangani pertanyaan leksikal secara deterministik. Ketika pengguna mencari kosakata tertentu, sistem mengambil data langsung dari kamus sehingga informasi yang berasal dari basis data tidak perlu diolah kembali oleh LLM dan risiko perubahan atau halusinasi dapat ditekan.
Jalur kedua menggunakan Conversation Retrieval untuk menyediakan contoh kalimat berdasarkan konteks percakapan sebelumnya. Dengan pendekatan tersebut, sistem dapat mempertahankan konteks sesi sehingga jawaban tidak berdiri sendiri dari percakapan yang sedang berlangsung.
Untuk pertanyaan yang membutuhkan pemahaman lebih mendalam, sistem menggunakan Retrieval-Augmented Generation (RAG). Modul ini mengambil informasi dari puluhan dokumen PDF ilmiah melalui pencarian berbasis kata kunci, kemudian memanfaatkan LLM Qwen 3.6:35b untuk menyusun jawaban berdasarkan sumber yang ditemukan.